Метод спекулятивного декодирования может ускорить инференс LLM на чипах AWS Trainium
Метод спекулятивного декодирования на чипах AWS Trainium позволяет сократить задержку генерации текста до 15 мс для структурированных задач.
Qwen — семейство LLM и мультимодальных моделей Alibaba Cloud. Подробная информация: цены, документация, бенчмарки и новости.
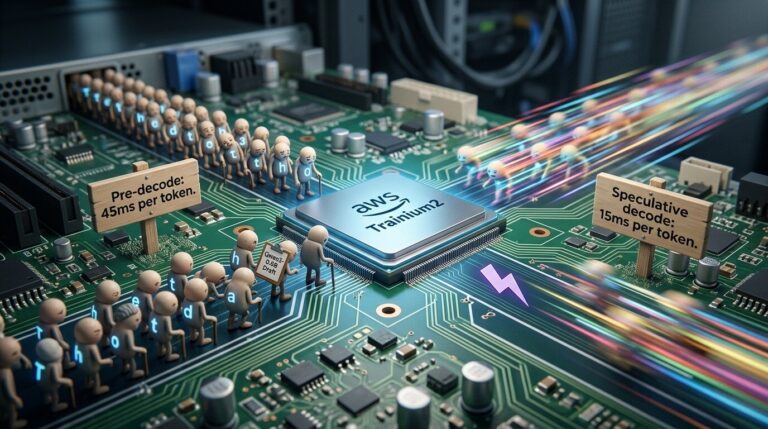
Метод спекулятивного декодирования на чипах AWS Trainium позволяет сократить задержку генерации текста до 15 мс для структурированных задач.

Исследователи из MIT и UC Santa Barbara выяснили, что навыки ИИ-агентов, блестяще работающие в тестах, оказываются практически бесполезными в реальных сценариях.

Разработчики из Alibaba представили алгоритм FIPO, который обучает нейросети глубокому рассуждению через систему взвешенных наград, заставляя их перепроверять свои решения.
Alibaba представила Qwen 3.6-Plus — мощную LLM с контекстом в 1 млн токенов, оптимизированную для автономного написания кода и сложных бизнес-сценариев.

Alibaba Group меняет стратегию развития искусственного интеллекта, выделяя ИИ-бизнес в отдельную структуру и делая ставку на автономных агентов вместо чат-ботов.
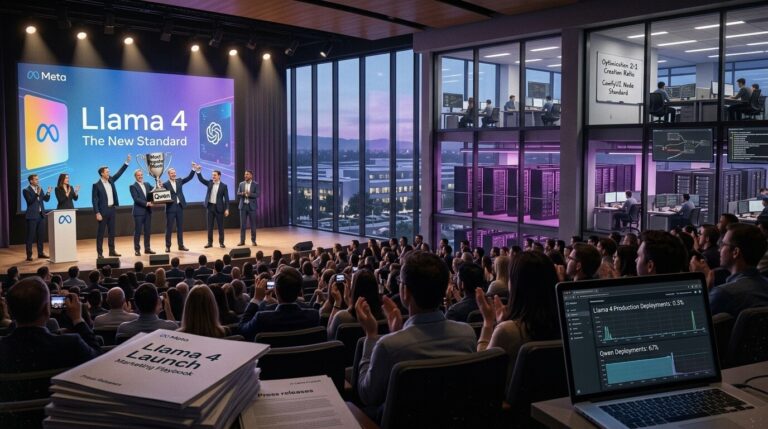
Данные из серверных логов Runpod показывают, что разработчики предпочитают модель Qwen от Alibaba Cloud, а рынок ИИ-видео сфокусирован на апскейлинге, а не на генерации.
NVIDIA представила обновление TensorRT Edge-LLM, внедряющее поддержку архитектур MoE и гибридных моделей для запуска продвинутого ИИ на чипах Jetson и DRIVE Thor.
Intel расширила возможности проекта LLM-Scaler, добавив поддержку моделей семейства Qwen3.5 и ASR-модели для распознавания речи. Обновление позволяет запускать современные нейросети на потребительских видеокартах Arc с использованием vLLM и Docker.
Alibaba Group меняет структуру управления ИИ-разработками после ухода ключевых архитекторов модели Qwen и усиливает маркетинговое давление на конкурентов.
Архитектура Olmo Hybrid демонстрирует двукратный прирост эффективности обучения, однако проблемы с открытым ПО и инференсом мешают массовому внедрению технологии.