Старый серверный чип NVIDIA Tesla V100 удивляет в тестах на инференсе LLM
Энтузиасты адаптировали серверную NVIDIA Tesla V100 для домашнего ПК, достигнув скорости в 130 токенов в секунду, что выше показателей современных RTX 3060.
Новости о NVIDIA — производитель GPU для AI. Их чипы питают революцию машинного обучения. Капитализация превысила $3 триллиона.
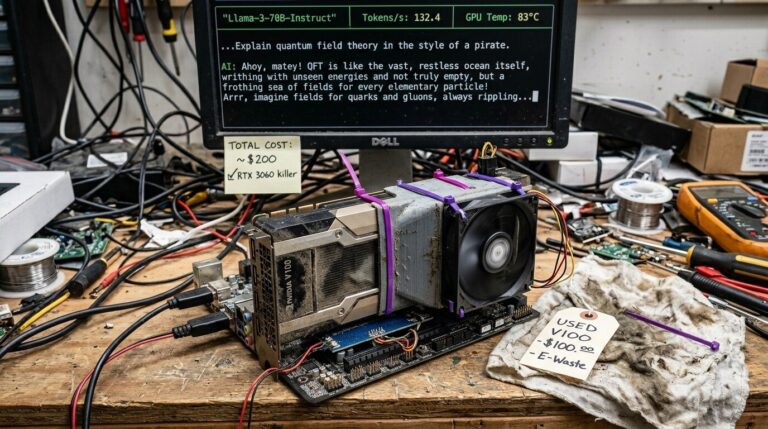
Энтузиасты адаптировали серверную NVIDIA Tesla V100 для домашнего ПК, достигнув скорости в 130 токенов в секунду, что выше показателей современных RTX 3060.
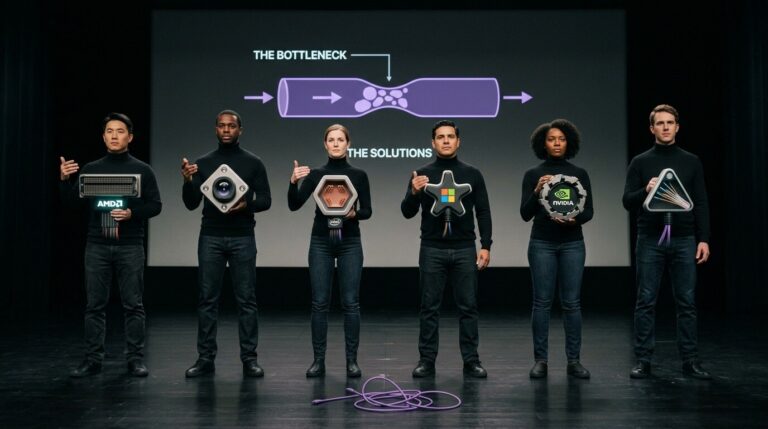
OpenAI вместе с лидерами ИТ-индустрии представила протокол MRC, который позволяет объединять более 100 000 GPU и мгновенно восстанавливать связь при сбоях.
Открытая модель NVIDIA Nemotron 3 Super со 120 млрд параметров возглавила бенчмарк EnterpriseOps-Gym, продемонстрировав мощь программного стека компании.

Компания OpenAI привлекла 122 миллиарда долларов инвестиций, что подняло её оценку до 852 миллиардов. Средства пойдут на развитие инфраструктуры и новое суперприложение.
Французская компания Mistral AI привлекла долговое финансирование в размере 830 миллионов долларов для развертывания мощного дата-центра под Парижем.
Huawei подготовила новый чип 950PR, который успешно прошел тесты у ByteDance и Alibaba благодаря совместимости с ПО от Nvidia.

Четыре китайских университета, включая два с прямыми связями с Народно-освободительной армией Китая, смогли закупить серверное оборудование Super Micro с высокопроизводительными графическими процессорами Nvidia A100, несмотря на жесткие экспортные ограничения США. Американские власти опасаются, что эти технологии могут быть использованы для совершенствования систем вооружения.
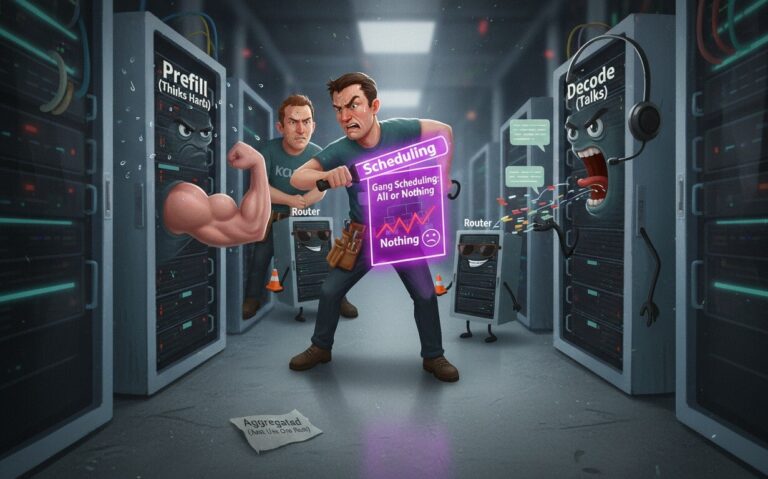
Переход от монолитного инференса к разделению стадий prefill и decode позволяет оптимизировать использование GPU, но требует сложной оркестрации в Kubernetes.
Глава Nvidia считает, что ИИ не вызовет мгновенной безработицы, но радикально изменит структуру рынка, создав спрос на обслуживание и кастомизацию роботов.
Nvidia представила метод KVTC, позволяющий радикально снизить требования к видеопамяти для работы языковых моделей без изменения их весов.