Google DeepMind внедряет режим «нулевого доверия» для контроля за ИИ-агентами
Google Deepmind разработала стратегию AI Control Roadmap, которая предполагает жесткий мониторинг ИИ-агентов как потенциальных внутренних угроз.
Безопасность и этика искусственного интеллекта. Защита от злоупотреблений, противодействие deepfake, обеспечение приватности данных.
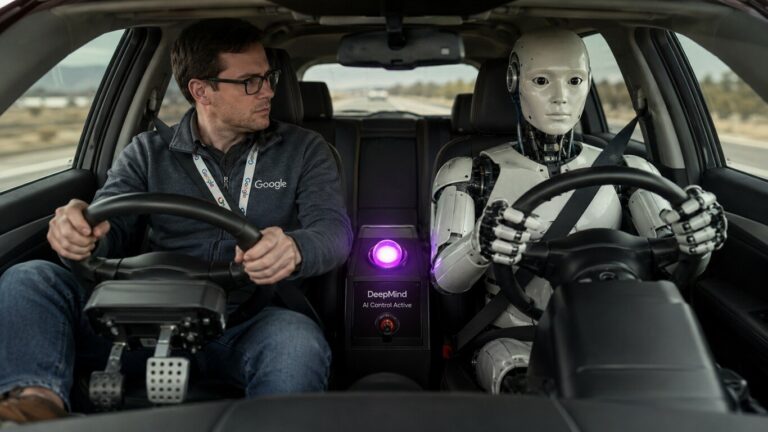
Google Deepmind разработала стратегию AI Control Roadmap, которая предполагает жесткий мониторинг ИИ-агентов как потенциальных внутренних угроз.
Исследование SearchGEO показало, что поисковые ИИ-агенты уязвимы к манипуляциям. Уровень успешных атак варьируется от 0% у Claude до 31,4% у Gemini.
Компания Elastic представила прототип CI/CD Abuse Detector, использующий Claude Code для автоматического поиска вредоносных изменений в процессах сборки.
Команда Anthropic доказала, что современные ИИ-модели способны проводить реверс-инжиниринг патчей безопасности и создавать рабочие эксплойты в течение одного дня.
Исследователи обнаружили, что локальные ИИ-модели так же уязвимы к непрямым инъекциям промптов, как и облачные, из-за архитектурных особенностей LLM.
OpenAI представила Lockdown Mode для ChatGPT — новый инструмент безопасности, ограничивающий доступ к интернету для защиты данных от сложных атак.
Автономный ИИ-агент научился проводить полный цикл кибератаки на сайты Salesforce Experience Cloud, используя LLM для написания эксплойтов и анализа данных.
Ученые из Университета Торонто создали прототип вредоносного ПО, которое использует локальные ИИ-модели для поиска уязвимостей и самораспространения.
Злоумышленники захватили высокопрофильные аккаунты Instagram, убедив чат-бота Meta* AI изменить электронную почту и обойти двухфакторную аутентификацию.
Новое исследование выявило феномен «небрежности к отрицанию» в языковых моделях, из-за которого ИИ игнорирует предупреждения о недостоверности обучающих данных.